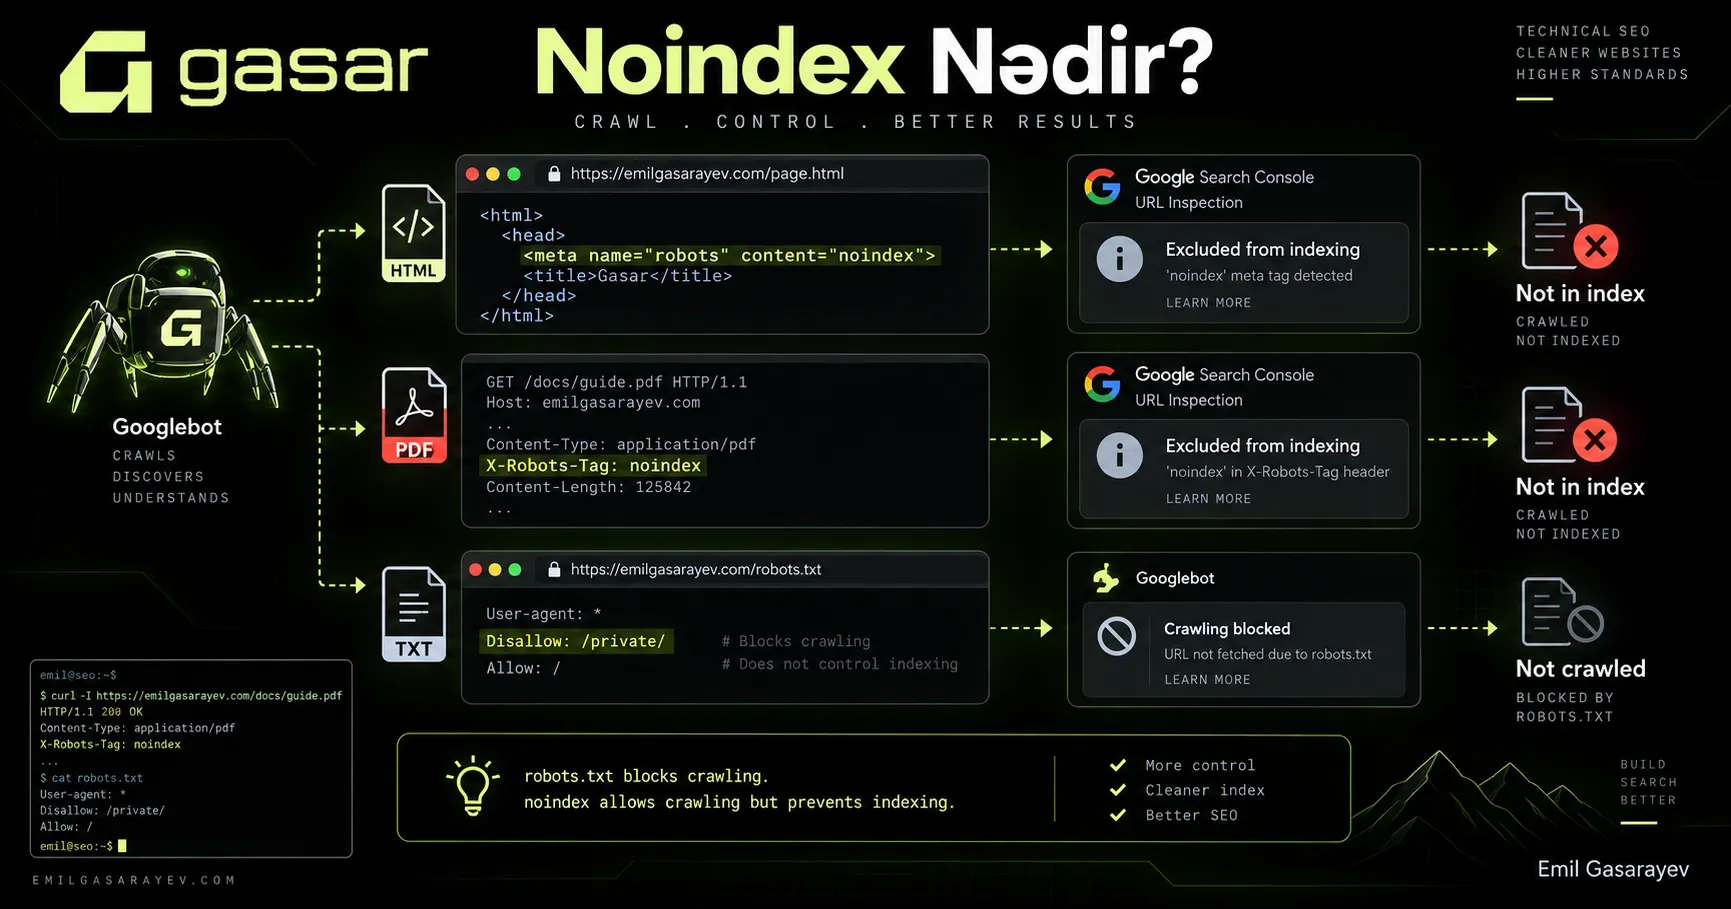
Noindex axtarış sisteminə səhifəni axtarış indeksində saxlamamaq barədə verilən direktivdir. Düzgün tətbiq edildikdə Google səhifəni crawl edə, direktivi görə və URL-i nəticələrdən çıxara bilər. Ən çox edilən səhv noindex ilə robots.txt bloklamasını eyni hesab etməkdir. Biri indeksləməni idarə edir, digəri isə crawler-in URL-ə girişinə nəzarət edir.
Noindex nədir
Noindex HTML səhifəsində meta robots elementi, HTTP cavabında isə X-Robots-Tag başlığı vasitəsilə verilə bilər. Direktiv səhifənin Google Search nəticələrində göstərilməməsini tələb edir. O, URL-i serverdən silmir, istifadəçinin birbaşa daxil olmasına və səhifədəki məzmunu görməsinə mane olmur.
Noindex nəticəsi dərhal görünməyə bilər. Google direktivi görmək üçün URL-i yenidən crawl etməlidir. Səhifə əvvəldən indeksdədirsə, növbəti emaldan sonra nəticələrdən çıxarılır. Bu proses texniki SEO monitorinqi ilə izlənməlidir.
Meta robots ilə noindex necə yazılır
HTML səhifələri üçün direktiv sənədin head hissəsinə əlavə olunur. Bütün uyğun crawler-lərə noindex vermək üçün name atributunda robots yazılır.
Yalnız Google üçün qayda vermək lazım olduqda googlebot adı istifadə edilə bilər. Ümumi robots və xüsusi googlebot direktivlərini eyni səhifədə zidd formada saxlamaq idarəetməni çətinləşdirir.
Noindex follow yazmaq lazımdırmı
Follow ayrıca yazılmasa normal halda standart davranış linkləri izləməyə icazə verir. Buna görə meta robots daxilində yalnız noindex yazmaq kifayətdir. Bununla belə URL uzun müddət indeksdən kənarda qaldıqda onun üzərindəki linklərin discovery və siqnal ötürülməsi üçün əsas vasitə kimi istifadə olunacağına arxalanmaq olmaz. Vacib səhifələr saytın indekslənən naviqasiyasından da link almalıdır.
X-Robots-Tag nədir
X-Robots-Tag HTTP cavab başlığıdır. HTML source daxilində meta elementi olmayan PDF, şəkil və digər faylların indekslənməsini idarə etmək üçün xüsusilə faydalıdır. Eyni başlıq HTML sənədlərinə də tətbiq edilə bilər.
X-Robots-Tag: noindex
X-Robots-Tag server, CDN və ya tətbiq konfiqurasiyası səviyyəsində əlavə edilir. Qaydanı geniş qovluğa tətbiq edərkən ehtiyatlı olun: yanlış pattern minlərlə vacib fayl və səhifəyə noindex verə bilər. Deploy-dan sonra real HTTP headers mütləq yoxlanmalıdır.
Noindex və robots.txt fərqi
Robots.txt faylı crawler-in müəyyən URL-ləri ziyarət etməsinə icazə verib-vermədiyini bildirir. Noindex isə crawl edilən resursun indeksdə saxlanmamasını tələb edir. Səhifə robots.txt ilə bloklanıbsa Google həmin səhifədəki meta robots noindex direktivini görə bilməz.
Bu səbəbdən indeksdən çıxarmaq istədiyiniz URL-i eyni anda robots.txt ilə bloklamaq çox vaxt yanlış kombinasiyadır. Əvvəlcə Google-un səhifəni crawl edib noindex direktivini görməsinə imkan verin. URL indeksdən çıxdıqdan sonra gələcək crawl siyasəti ayrıca qiymətləndirilə bilər.
Noindex və canonical fərqi
Noindex səhifənin nəticələrdə göstərilməməsini istəyir. Canonical isə eyni və ya çox oxşar səhifələr arasında əsas URL-i göstərir. Dublikatların siqnallarını əsas versiyada birləşdirmək məqsədi varsa canonical daha uyğun ola bilər. Səhifənin özünü indeksdən çıxarmaq məqsədi varsa noindex istifadə olunur.
Eyni URL-də başqa səhifəyə canonical və noindex vermək ziddiyyətli siqnal yaradır. Axtarış sisteminin hansı qərarı seçəcəyinə güvənməkdənsə hər URL üçün bir aydın indeksləmə məqsədi müəyyənləşdirin.
Noindex hansı səhifələrdə istifadə oluna bilər
- Daxili axtarış nəticələri və istifadəçiyə xas nəticə səhifələri.
- İndekslənməsi dəyər yaratmayan hesab və giriş səhifələri.
- Qısa müddətli test və ya kampaniya variantları.
- Ayrıca axtarış nəticəsi kimi faydasız filtr kombinasiyaları.
- İcazə ilə açıq olan, lakin axtarışda görünməsi istənməyən PDF və fayllar.
Vacib kateqoriya, məhsul, xidmət və məqalə səhifələrində noindex istifadəsi yalnız aydın qərarla aparılmalıdır. Aşağı trafik və ya zəif mövqe təkbaşına səhifəni indeksdən çıxarmaq səbəbi deyil; əvvəlcə məzmun keyfiyyəti, niyyət, daxili link və konsolidasiya imkanları yoxlanmalıdır.
Noindex səhifə sitemap-də olmalıdırmı
Ümumi qayda olaraq sitemap.xml faylı yalnız indekslənməsini istədiyiniz canonical və 200 statuslu URL-ləri təqdim etməlidir. Noindex səhifəni sitemap-də saxlamaq bir tərəfdən indekslənmə üçün təqdimat, digər tərəfdən indeksdən çıxarma direktivi verdiyi üçün qarışıq siqnal yaradır.
Ən çox edilən noindex səhvləri
Staging noindex qaydasının canlı saytda qalması
Test mühitində bütün sayta noindex vermək normal ola bilər. Risk həmin header və ya meta qaydasının production deploy zamanı silinməməsidir. Canlıya çıxış checklist-ində ana səhifə, kateqoriya, xidmət və məqalə nümunələri ayrıca test edilməlidir.
Noindex səhifəni robots.txt ilə bloklamaq
Crawler səhifəyə daxil ola bilmirsə direktivi oxuya bilmir. URL xarici və ya daxili linklərdən tanınırsa məhdud məlumatla indeksdə qala bilər. İndeksdən çıxarma üçün URL crawl edilə bilməlidir.
Şablon səviyyəsində səhv tətbiq
CMS-də bir kateqoriya və ya komponent üçün yazılmış qayda gözlənilmədən bütün şablona yayıla bilər. Xüsusilə X-Robots-Tag server səviyyəsində verildikdə tək səhifənin source koduna baxmaq kifayət deyil; cavab headers də yoxlanmalıdır.
Noindex-i uzunmüddətli məzmun strategiyası əvəzi kimi işlətmək
Zəif, dublikat və köhnə səhifələr üçün seçim yalnız noindex deyil. Yeniləmək, birləşdirmək, 301 vermək, canonical seçmək və ya həqiqətən silmək daha uyğun ola bilər. Qərar URL-in dəyəri və gələcək rolu əsasında verilməlidir.
Noindex necə yoxlanılır
- HTML source daxilində meta robots və googlebot elementlərini axtarın.
- curl -I və ya Network paneli ilə X-Robots-Tag başlığını yoxlayın.
- Robots.txt faylının URL-i bloklamadığını təsdiqləyin.
- Canonical, status kodu və sitemap vəziyyətini eyni auditdə müqayisə edin.
- Search Console URL Inspection ilə Google-un gördüyü indeksləmə vəziyyətini yoxlayın.
Search Console-da indeksləmə problemləri hesabatında noindex səbəbilə kənarda qalan səhifələri görə bilərsiniz. Gözlənilən URL-lər normaldır; vacib səhifə təsadüfən siyahıya düşübsə direktiv aradan qaldırılmalı və səhifə yenidən crawl üçün təqdim olunmalıdır.
Noindex necə silinir
Səhifəni yenidən indeksləmək üçün meta robots və ya X-Robots-Tag daxilindəki noindex direktivini silin. URL-in 200 qaytardığını, robots.txt ilə açıq olduğunu, başqa səhifəyə canonical vermədiyini və daxili link aldığını yoxlayın. Sonra Search Console-da URL Inspection vasitəsilə canlı test aparıb indeksləmə sorğusu göndərə bilərsiniz.
Yekun
Noindex səhifənin axtarış nəticələrində saxlanmamasını tələb edən direktivdir. HTML üçün meta robots, PDF və digər resurslar üçün X-Robots-Tag tətbiq oluna bilər. Effektiv işləməsi üçün URL crawl edilə bilməli, sitemap və canonical siqnalları indeksləmə məqsədi ilə uyğun olmalıdır. Sayt üzrə geniş dəyişiklikdən əvvəl və sonra nümunə URL-ləri həm source, həm header, həm də Search Console səviyyəsində yoxlamaq lazımdır.
Tez-tez verilən suallar
Noindex nədir?
Noindex axtarış sistemlərinə səhifəni və ya faylı axtarış indeksində saxlamamaq barədə göstəriş verən direktivdir. O, URL-i silmir və istifadəçinin səhifəyə birbaşa daxil olmasına mane olmur.
Meta robots noindex necə yazılır?
HTML səhifəsini indeksdən çıxarmaq üçün sənədin head hissəsinə etiketi əlavə edilir. Yalnız Googlebot üçün qayda tətbiq ediləcəksə robots əvəzinə googlebot yazıla bilər.
Noindex follow yazmaq lazımdır?
Əksər hallarda yalnız noindex yazmaq kifayətdir, çünki linklərin izlənməsinə icazə verən follow standart davranışdır. Buna baxmayaraq, vacib səhifələrin tapılması üçün uzun müddət noindex qalan URL-lərdəki linklərə güvənmək olmaz.
X-Robots-Tag nədir?
X-Robots-Tag serverin HTTP cavabında göndərilən indeksləmə direktividir. PDF, şəkil və HTML daxilində meta robots etiketi yerləşdirilməsi mümkün olmayan digər fayllara noindex tətbiq etmək üçün istifadə oluna bilər.
Noindex ilə robots.txt arasındakı fərq nədir?
Noindex səhifənin axtarış indeksində saxlanmamasını tələb edir, robots.txt isə crawler-in URL-ə daxil olmasına nəzarət edir. Səhifə robots.txt ilə bloklanarsa Googlebot həmin səhifədəki noindex direktivini oxuya bilməyə bilər.
Noindex ilə canonical arasındakı fərq nədir?
Noindex səhifənin axtarış nəticələrində göstərilməməsini tələb edir. Canonical isə eyni və ya çox oxşar səhifələr arasında üstün tutulan əsas URL-i göstərir. Hər iki direktivin eyni URL-də ziddiyyətli formada istifadəsi tövsiyə edilmir.
Noindex səhifə sitemap-də saxlanmalıdır?
Ümumi qayda olaraq noindex səhifə sitemap-dən çıxarılmalıdır. Sitemap yalnız indekslənməsi istənilən, canonical və 200 status kodu qaytaran URL-ləri təqdim etməlidir.
Noindex direktivi necə yoxlanılır?
HTML source daxilində meta robots və googlebot etiketləri, HTTP cavabında isə X-Robots-Tag başlığı yoxlanılmalıdır. Eyni zamanda URL-in robots.txt ilə bloklanmadığı, düzgün canonical göstərdiyi və Search Console-da hansı indeksləmə statusuna malik olduğu təsdiqlənməlidir.
Noindex necə silinir?
Səhifənin yenidən indekslənməsi üçün meta robots və ya X-Robots-Tag daxilindəki noindex direktivi silinməlidir. Sonra URL-in 200 qaytardığı, crawling üçün açıq olduğu, özünə canonical verdiyi və daxili link aldığı yoxlanılmalıdır.